dukongmon
Stack & DFS 본문
그래프 탐색 대표 알고리즘 DFS / BFS
- 탐색(Search)란 많은 양의 데이터 중에서 원하는 데이터를 찾는 과정
- 코테에서 매우 자주 등장하는 유형
Stack
- 리스트의 한쪽 끝에서 수행되는 선형 리스트의 한가지 형태
- 입구와 출구가 동일한 형태
- LIFO(Last In First Out) 구조 : 선입후출 형태로 스택에 마지막으로 입력된 자료가 제일 먼저 삭제되는 구조
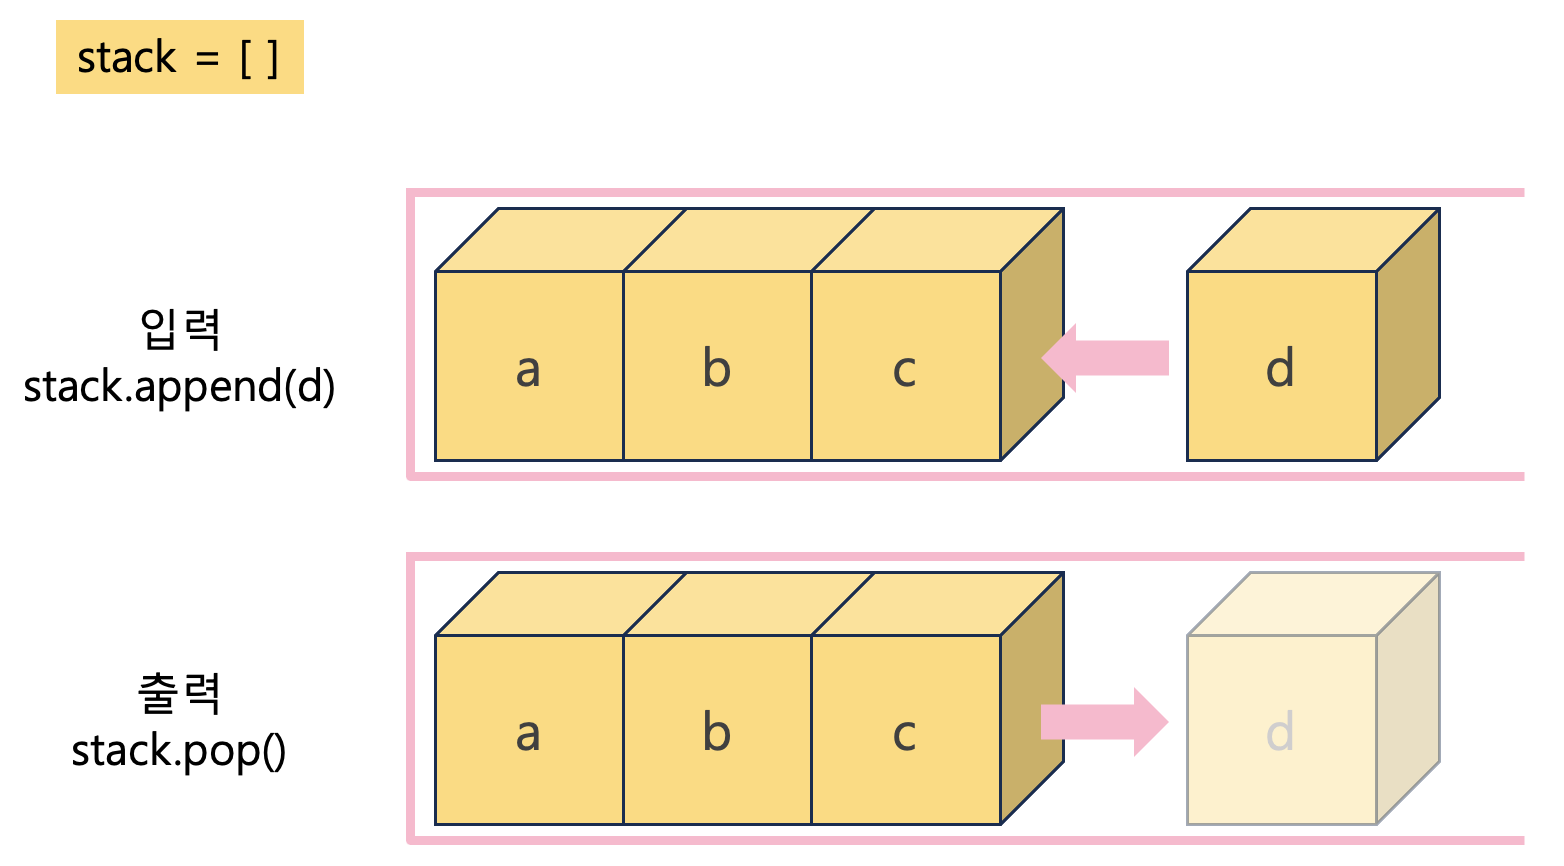
깊은 상자라고 생각했을 때 차곡차곡 넣는데, 마지막에 넣은걸 먼저 꺼낼 수 있는 구조!
EX ) 삽입(5) - 삽입(2) - 삽입(3) - 삽입(7) - 삭제() - 삽입(1) - 삽입(4) - 삭제()
⇒ 5 2 3 7 1 4
stack = []

# 삽입(5)-삽입(2)-삽입(3)-삽입(7)-삭제()-삽입(1)-삽입(4)-삭제()
stack.append(5)
stack.append(2)
stack.append(3)
stack.append(7)
stack.pop()
stack.append(1)
stack.append(4)
stack.pop()

# 넣은 순서대로 stack list 출력
print(stack)
# 출구에 가까운 순으로 stack list 출력
print(stack[::-1])
[5, 2, 3, 1]
[1, 3, 2, 5]- 스택의 append()와 pop()의 시간복잡도는 O(1). 상수시간
DFS(Depth-First Search) : 깊이우선탐색
그래프 탐색 : 하나의 정점에서 시작해서 차례대로 모든 정점들을 한번씩 방문하는 것.
DFS : 루트 노드 또는 다른 임의의 노드에서 시작해서 다음 분기(branch)로 넘어가기 전에 해당 분기를 모두 탐색하는 방법.
즉, 넓게(wide) 탐색하기 전에 깊게(deep) 탐색하는 것.
모든 노드를 방문하고자 하는 경우 이 알고리즘을 선택하며, BFS(너비우선탐색)보다 좀 더 간단하지만 검색 속도는 더 느리다.
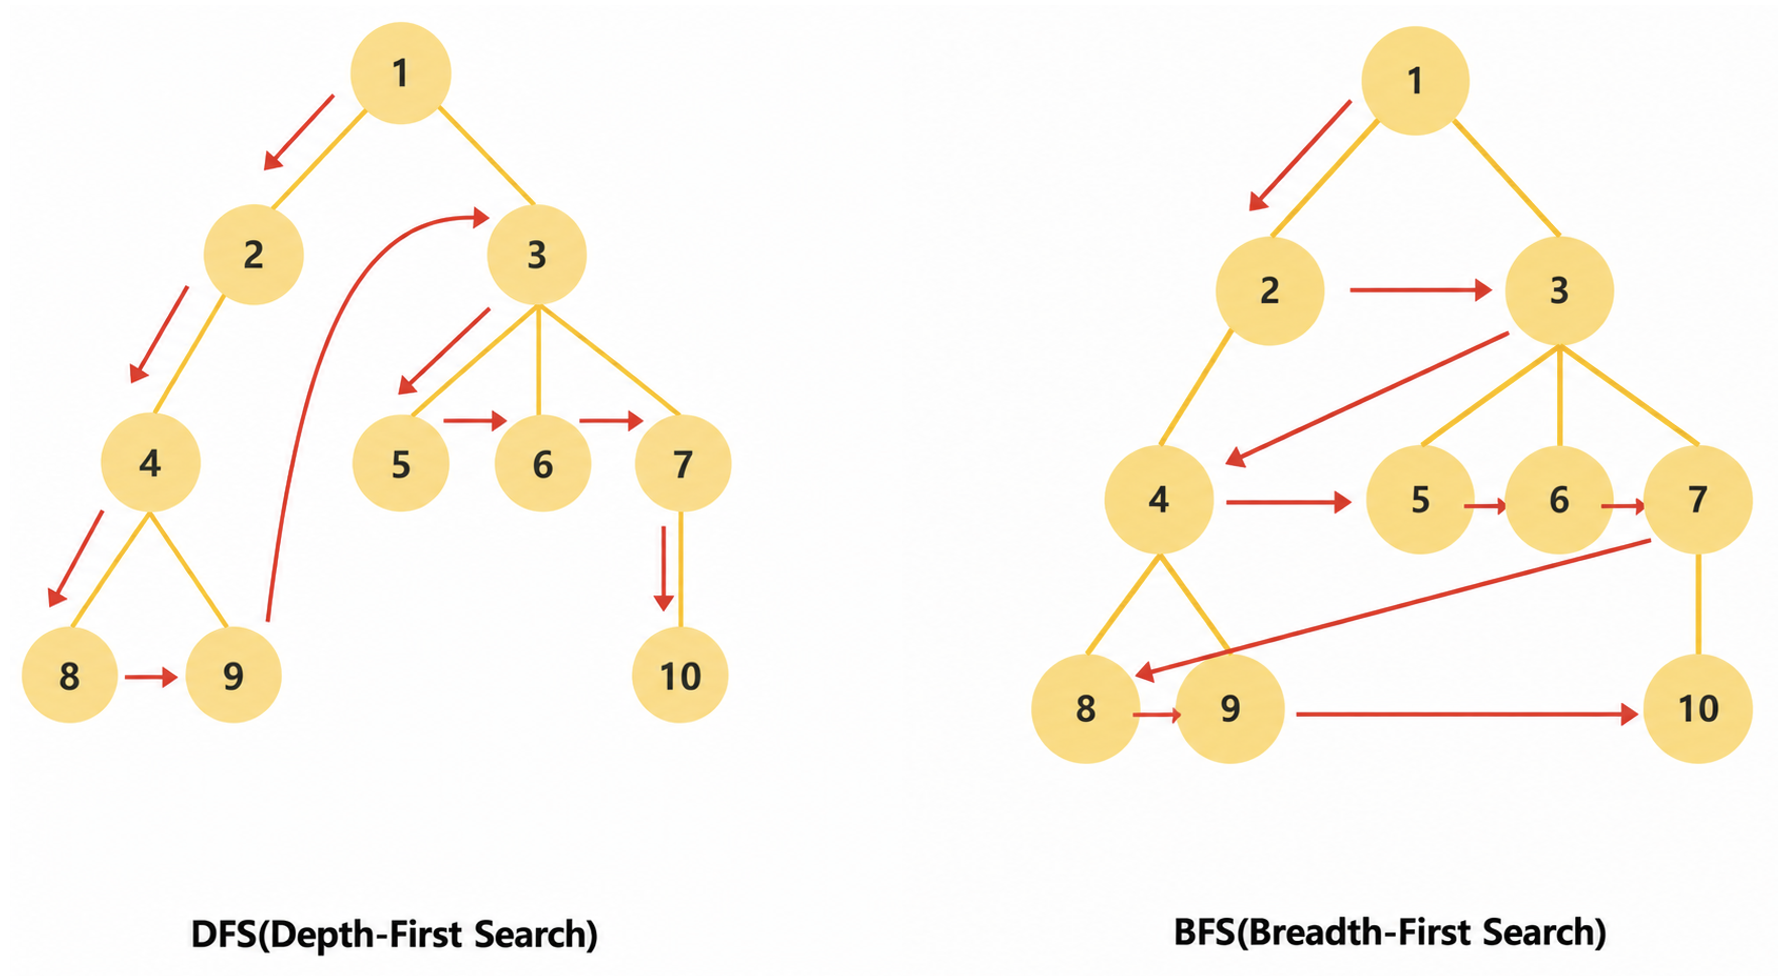
DFS 특징
- 자기 자신을 호출하는 순환 알고리즘의 형태를 가지고 있음
- 전위 순회(Pre-Order Traversals)를 포함한 다른 형태의 트리 순회는 모두 DFS의 한 종류.
- 중요한 특징은 그래프 탐색의 경우 무한 루프에 빠질 수 있기 때문에 어떤 노드를 방문했었는지 여부를 반드시 검사해야 함.
또 데이터를 찾을 때는 항상 앞으로 방문할 노드와 이미 방문한 노드를 기준으로 데이터를 탐색해야함. - DFS는 스택/큐를 활용할 수도 있고, 재귀함수를 통해 구현할 수도 있음
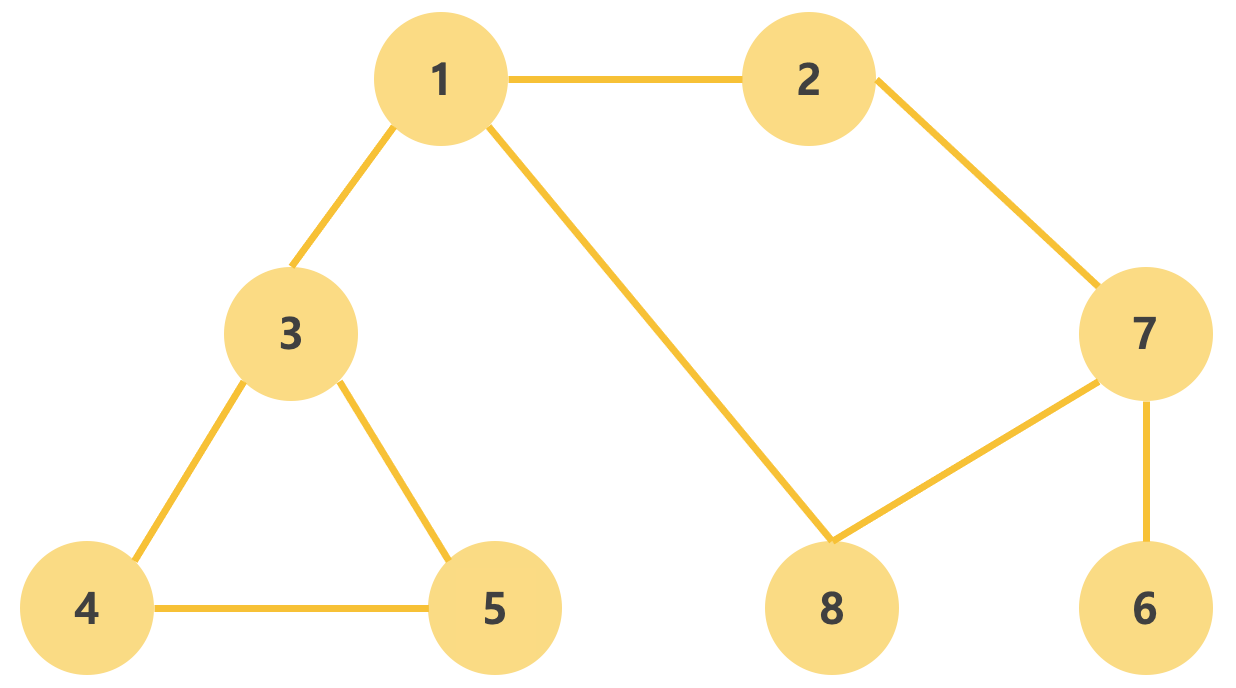
def dfs(graph, v, visited) :
    visited[v] = True
    print(v, end=' ')
    for i in graph[v] :
        if not visited[i] :
            dfs(graph, i, visited)

# 스택 호출 인덱스를 고려해서 0번째는 빈 리스트로 두기
# 호출 인덱스 번호와 연결된 노드들로 구성된 리스트 만들기
graph=[
    [],
    [2,3,8],
    [1,7],
    [1,4,5],
    [3,5],
    [3,4],
    [7],
    [2,6,8],
    [1,7]
]

visited = [False]*9
# print(visited)

dfs(graph,1,visited)
1 2 7 6 8 3 4 5
재귀 함수(Recursive Function)
자기 자신을 다시 호출하는 함수를 의미DFS, BFS에서 많이 사용함무한히 재귀 함수를 반복하면 어느정도 출력하다 최대 재귀 깊이 초과 메시지 출력됨RecursionError: maximum recursion depth exceeded while call
kongs-code.tistory.com
참고 : 동빈나 DFS & BFS
'Python > Algorithm & Data Structure' 카테고리의 다른 글
| MST와 Union-Find, Kruskal 알고리즘 (0) | 2026.06.12 |
|---|---|
| Queue & BFS (0) | 2026.06.08 |
| 재귀 함수(Recursive Function) (0) | 2026.06.08 |
'Python/Algorithm & Data Structure' Related Articles
more

